做批量剪辑这行,真正耗时间的往往不是剪本身。
是那些重复的小动作。
就说加字幕这件事。片子本身十分钟能剪完,但你要给五十条视频都加上同样的文字——产品名、价格、活动时间。样式全都一样,可你还是一条一条打开、摆位置、调颜色。
一条两分钟,五十条就是一百多分钟。
我以前是这么干的
打开参数面板,填一组数字坐标。跑一条出来看看效果,位置偏了,改数字,再跑一条。反复三四次,才把位置定准。
定准之后也不好受——那组数字得记着,下次换一批视频,还得重新试。
现在这一步改掉了
新版本把「字体预设」做成了可视化的。
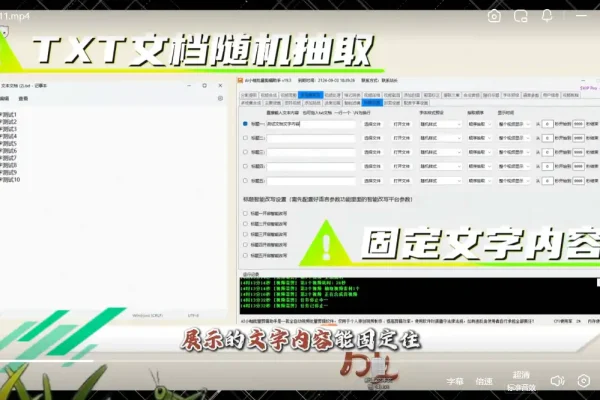
打开软件进字体预设,点新建,会弹出一个本地浏览器窗口。文字长什么样,就在那个窗口里直接调,看到的就是最后加在视频上的效果。
分辨率先定好,这决定了文字的显示范围有多大。字体要换的话,电脑里装好就能直接调用。
位置这块的改动很明显。
选了上下位置,就只调垂直边距;选了左右,就只调水平边距。想摆到任意一个地方,选中四个角的箭头,鼠标拖过去就行。
不用再猜数字了。
调完保存,给它起个名字。以后要用,选名字就行。
文字内容从哪来
预设只管样式。具体加什么字,还有一套设置。
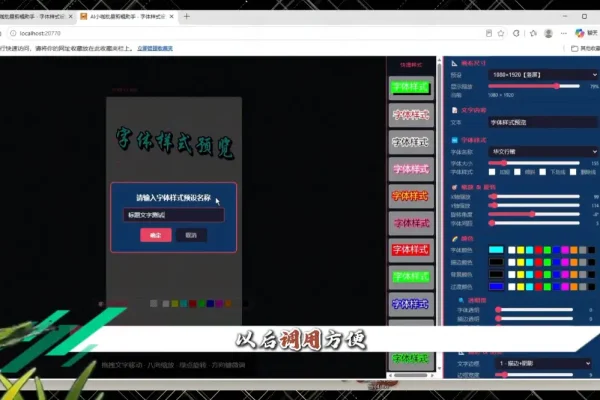
如果每条视频加的内容一样,直接把文字填进去就行。
如果不一样——比如每条视频要显示不同的商品名——那就把这些文字写进一个 TXT 文档,一行一句。生成的时候,软件会自动一行一行往下抽,不用你手动分。
我一般是按批次写。一批货一个 TXT,跑完了再换下一批。
字幕是另一种情况
字幕不是提前写好的,是从视频里的声音识别出来的。
这个流程跟上面是一个思路,也是先把预设配好,然后在出片页面把「自动字幕」勾上。
识别的模型可以用本地跑的,也可以接第三方平台,看你自己电脑的配置。
跑起来之后,软件会逐段识别每条视频里的人声,再套上刚才设好的样式,把字幕加进去。
字幕的位置、颜色、大小,跟预设一致。
省下来的是什么
以前给五十条视频加文字加字幕,一下午起步。
现在把这套配好,剩下的活就是往文件夹里丢视频,点一下开始。
重复劳动没有了。留下的是需要判断的那部分——文案怎么写、节奏怎么排、哪条视频值得留。
那部分,本来也该花时间。
 admin